What Are Vision-Language-Action Models? The Foundation of General-Purpose Robots
· unite.ai · popularity 17/100 · 0 similar stories today · Robotics & Automation (Artificial Intelligence)
Read the original at unite.ai →
Summary
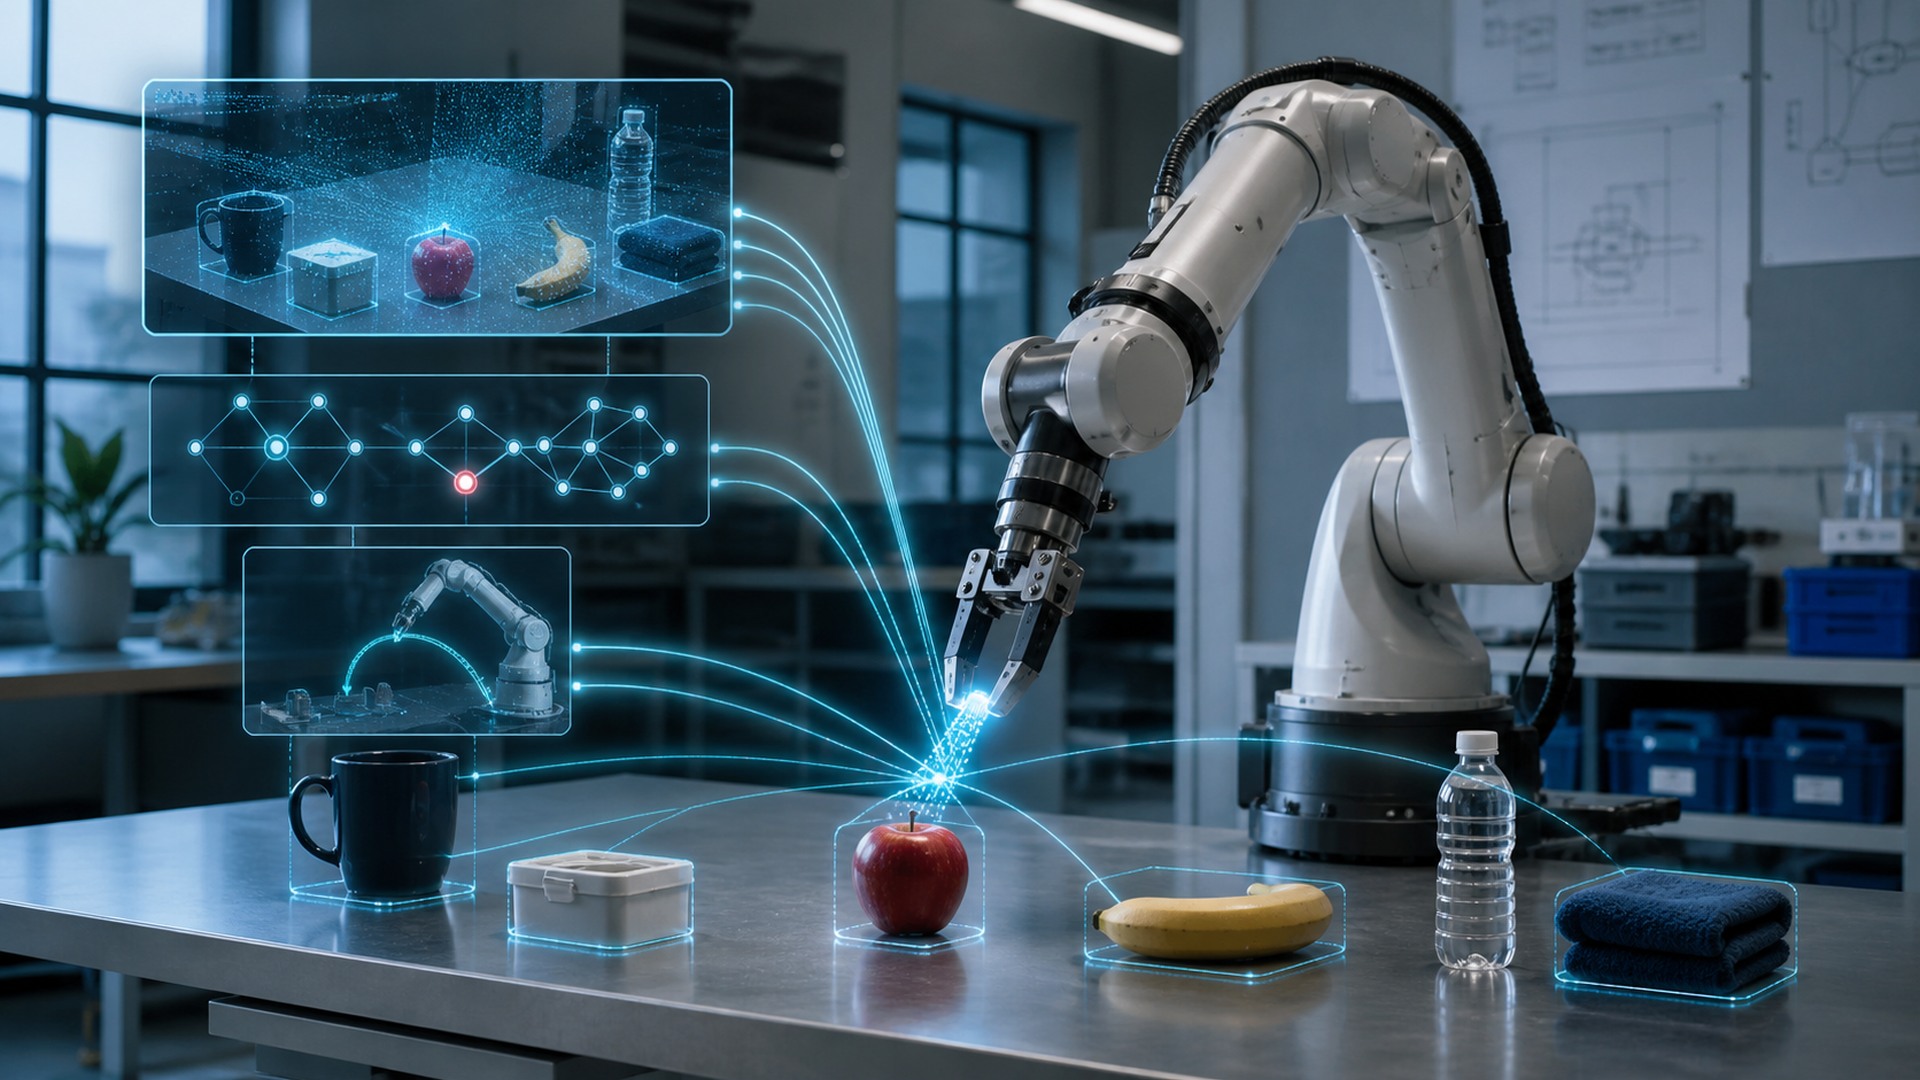
Vision-language-action models connect visual perception and language instructions to sequences of physical actions for embodied systems. This guide explains the mechanism, trade-offs, evaluation, and controls that matter in practice.
Found in: Unite.AI. Rating basis: single outlet; outlet tier 2 (unlisted); 1 feeds; feed position 13.